Du willst ungeplante Stillstände schnell reduzieren und suchst klare, umsetzbare Schritte? Hier bekommst du einen fokussierten Plan: von sensorbasierter Zustandsüberwachung bis zu Abläufen, die Ausfallzeiten messbar senken. So findest du den kürzesten Weg von Daten zu Entscheidungen – ohne monatelange Pilotstarre.
Kurzübersicht
- Starte mit Vibration und Temperatur an kritischen Anlagen: Sie liefern innerhalb weniger Tage verwertbare Anomalie-Hinweise.
- Richte Schwellenwerte mit einfachem Basismodell ein, bevor komplexe Predictive Models folgen – das bringt sofortige Alarme.
- Verkürze MTTR mit klaren Eskalationsregeln: Wer alarmiert wird, entscheidet und dokumentiert, steht im Wartungsplan.
- Nutze ein zentrales Dashboard für Fehler-Alarm und Trendverläufe, damit Schichten konsistent handeln.
- Priorisiere Assets nach Ausfallkosten pro Stunde; beginne dort, wo jeder vermiedene Stopp am meisten spart.
Kurzfristig Ausfallzeiten senken: Darum geht’s
Im Fokus stehen schnelle Effekte durch Zustandsüberwachung, einfache Anomalieerkennung und eine schlanke Datenpipeline bis zum Alarm. Rechtliche und organisatorische Basics zur KI-Nutzung haben wir hier praxisnah beleuchtet: KI im Unternehmen einsetzen: Datenschutz, Risiken und Praxistipps. Gleich danach zeige ich, wie du Maßnahmen nach Aufwand, Datenlage und erwarteter Ausfallreduktion priorisierst – und wie dein Instandhaltungsteam diese Schritte in den laufenden Betrieb überführt.
Welche KI-Methoden helfen wirklich bei ungeplanten Stillständen?
Für schnelle Effekte in der Produktion brauchst du keine vollumfängliche Data-Science-Abteilung. Drei Bausteine liefern kurzfristig Ergebnisse: zustandsbasierte Überwachung, KI-gestützte Anomalieerkennung und vorausschauende Wartung. Sie greifen ineinander, lassen sich modular starten und auf einzelne Linien oder Aggregate begrenzen.
Zustandsüberwachung: Vom Sensor zum verständlichen Signal
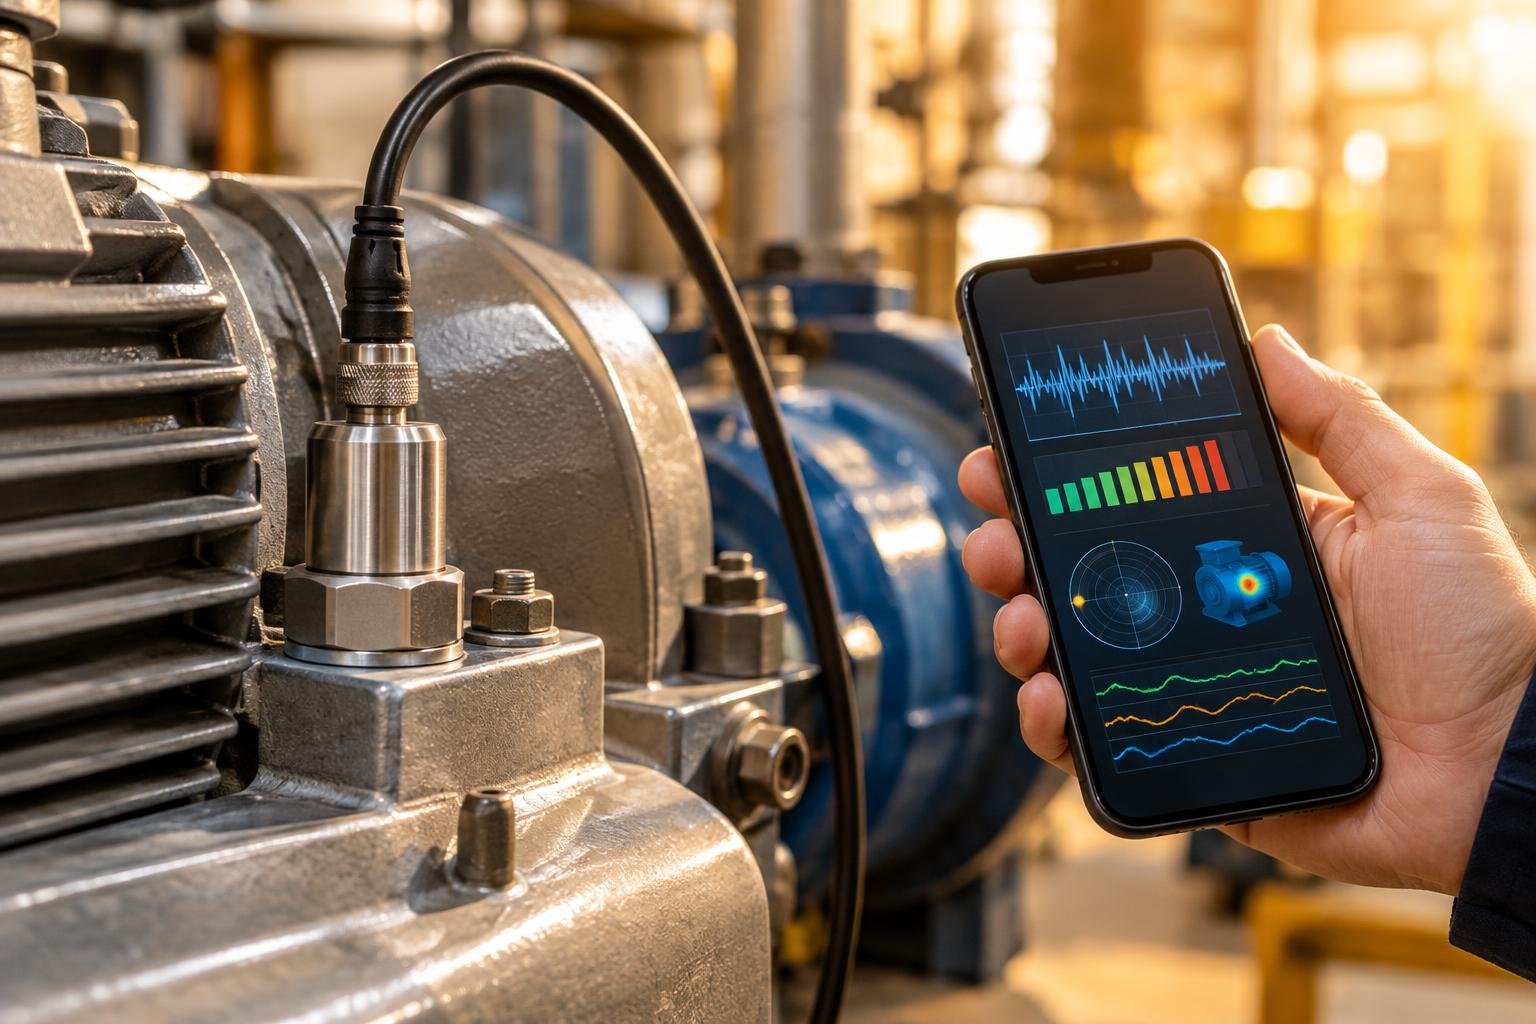
Beginne mit wenigen, robusten Signalen: Vibration und Temperatur an kritischen Lagern und Antrieben. Eine leichte Edge-Vorverarbeitung (z. B. RMS, Peak, Temperaturtrend) reduziert Datenmenge und Latenz. Über eine schlanke Datenpipeline landen die Kennwerte im Dashboard – idealerweise mit klaren Grenzwerten und einem einfachen Fehler-Alarm für das Instandhaltungsteam. Ziel: frühzeitige Abweichungen erkennen, bevor MTTR steigt oder MTBF fällt.
Für aktuelle Brancheneinordnungen und weitere Praxisbeispiele verweise ich auf diese Wirtschafts Webseite. Dort findest du ergänzende Einblicke, wie Unternehmen Sensorik und Anomalieerkennung pragmatisch koppeln, ohne die Produktion zu stören.
Predictive Maintenance: Vom Muster zur Handlung
Aufbauend auf der Überwachung lernt ein leichtgewichtiges Modell typische Muster: stabile Betriebszustände, Lastwechsel, Anfahrphasen. Ungewöhnliche Kombinationen werden als Anomalie markiert – nicht als „Defekt“, sondern als Prüfhinweis mit Zeitstempel, Maschinendaten (Vibration, Temperatur) und kurzer Root-Cause-Hypothese. Wichtig ist die Brücke zur Ablauforganisation: Integrationsschnittstellen (API) schreiben Hinweise direkt in Wartungsplan oder Ticket-System, inklusive Priorität und geschätztem Restlaufzeitfenster.
Wenn du schnell Orientierung bei der Priorisierung suchst, hilft dir unser Ansatz, Inhalte klar zu strukturieren – ein passender Startpunkt ist Vom Ratgeber zur Empfehlung: Warum Listicles Orientierung schaffen. Übertrage das Prinzip auf deine Maßnahmenliste: wenige, klar benannte Schritte – von Sensorplatzierung bis zum ersten Alarm-Workflow.
Qualitätsprüfung als Hebel gegen Folgeschäden
Neben reiner Ausfallvermeidung senkt eine einfache visuelle Prüfung mit KI oft teure Ketteneffekte: Kameras erfassen Oberflächen oder Montagezustände, ein schlankes Modell flaggt Ausreißer. So stoppst du Fehlläufe früh und reduzierst unplanmäßige Eingriffe am Ende der Linie. Wichtig: wenige, stabile Features, nachvollziehbare Regeln zur Sperrung und ein schneller Rückkanal ins Team.
Praxisplan: Sofortmaßnahmen (1–2 Wochen) und Projekte (bis 3 Monate)
Starte klein, aber sichtbar: Ein klarer Ablauf, minimale Technik und feste Verantwortlichkeiten bringen oft schon nach wenigen Tagen weniger ungeplante Stops. So gehst du vor.
Sofort (Woche 1–2): Ausfälle schneller erkennen und entschärfen
- Sensordaten prüfen: Erhebst du bereits Vibration und Temperatur? Falls ja, stelle sicher, dass Messfrequenz und Zeitstempel konsistent sind. Falls nein, beginne an der kritischsten Maschine mit einfachen Vibrationsaufnehmern und nutze bestehende Steuerungsdaten.
- Schwellwerte definieren: Lege je Maschine 2–3 klare Grenzwerte fest (z. B. RMS-Vibration, Lagertemperatur). Nutze einfache Regeln, um „Auffällig“ von „Kritisch“ zu trennen und reduziere Fehlalarme.
- Alarmwege festziehen: Wer bekommt wann eine Meldung und über welchen Kanal? Dokumentiere Rufbereitschaft, Eskalationsstufen und Rückmeldepflichten in einem kurzen One-Pager.
- Quick-Dashboard: Ein leichtgewichtiges Dashboard (Edge oder bestehendes HMI) mit Ampellogik pro Aggregat reicht – Ziel ist Reaktionszeit senken, nicht Perfektion.
Tipp: Lege pro Anlage eine 15‑Minuten‑Checkroutine zu Schichtbeginn fest (Vibration, Temperatur, Geräusch) und trage Abweichungen sofort im Dashboard ein.
Für die Umsetzung von Monitoring und Alarmierungskanälen ist ein gut organisiertes Intranet oder Kommunikationskanal wichtig; hier geht es um Grundlagen: Was ist ein Intranet? Definition, Funktionen und Vorteile.
Nächste 4–12 Wochen: Von Regeln zu Anomalieerkennung und PM
- Mini-Pilot Predictive Maintenance: Wähle eine Maschine mit klarer Störungshistorie. Trainiere ein einfaches Anomalie-Modell auf Basis von Normalzuständen (Vibration/Temperatur) und vergleiche Treffer mit Wartungsprotokollen.
- Datenpipeline stabilisieren: Einheitliche Zeitbasis, fehlende Werte markieren, Versionierung der Schwellwerte/Modelle festhalten. Edge-Computing nutzen, wenn Latenz oder Bandbreite knapp sind.
- Wartungsplan koppeln: Übersetze Alarme in konkrete Tasks mit ETA und benötigten Ersatzteilen. Messe MTTR/MTBF vor und nach Einführung, um Wirkung sichtbar zu machen.
- Root-Cause-Snippets: Für wiederkehrende Muster kurze Ursachensteckbriefe anlegen (Symptom, vermutete Quelle, Prüfschritt) – spart Analysezeit beim nächsten Alarm.
Häufiger Fehler: Nur auf ein einzelnes KI‑Tool setzen, ohne Datenqualität und Betriebsprozesse anzupassen.
So vermeidest du ihn: Vor einem Tool-Launch eine kurze Bestandsaufnahme durchführen: 1) Datenquellen und Messfrequenz prüfen, 2) Verantwortlichkeiten für Alarme festlegen, 3) Pilot an einer Maschine mit klaren Erfolgskriterien starten.
Mini‑Matrix zur Priorisierung (3×3)
Bewerte jede Maßnahme nach Implementierungsaufwand, Datenverfügbarkeit und erwarteter Ausfallreduktion. Beginne oben rechts: hohe Wirkung, niedriger Aufwand, vorhandene Daten.
| Maßnahme | Aufwand | Datenlage | Erwartete Wirkung |
|---|---|---|---|
| Schwellwert‑Alarme für Vibration/Temperatur | Niedrig | Vorhanden | Mittel bis hoch (schnelle Reaktion) |
| Quick‑Dashboard mit Ampellogik | Niedrig | Vorhanden | Mittel (Transparenz, MTTR runter) |
| Anomalieerkennung an Engpassmaschine | Mittel | Ausreichend | Hoch (Früherkennung) |
| Wartungsplan an Alarme koppeln | Mittel | Vorhanden | Mittel bis hoch (weniger Doppelarbeit) |
| Root‑Cause‑Steckbriefe | Niedrig | Vorhanden | Mittel (schnellere Diagnose) |
| Edge‑Vorverarbeitung | Mittel | Teilweise | Mittel (stabile Signale) |
Häufige Fragen & Handlungsempfehlung
Wie viele Daten brauche ich für einen sinnvollen Start?
Beginne mit dem, was bereits an der Maschine anliegt (Vibration, Temperatur, Stromaufnahme). Für erste Anomalieerkennung genügen oft wenige Tage bis Wochen an sauberen Daten, sofern sie lückenarm sind. Wichtig ist eine einfache Datenpipeline: konsistente Timestamps, einheitliche Einheiten und klare Maschinenzustände (Produktion, Leerlauf, Stopp) als Labels.
Reicht Regelwerk, oder brauche ich sofort KI-Modelle?
Starte hybrid. Setze pragmatische Schwellwerte für akute Risiken (Übertemperatur, Vibration-Sprünge) und ergänze sie um ein leichtgewichtiges Anomalie-Modell, das Muster über mehrere Sensoren erkennt. So senkst du Fehlalarme und gewinnst Zeit, während historische Daten für robustere Predictive-Modelle wachsen.
Wie integriere ich Alarme ohne Alarmmüdigkeit?
Weniger Kanäle, klarere Regeln: Ein Prioritätsschema (P1 = sofort stoppen, P2 = geplanter Eingriff, P3 = beobachten) plus feste Eskalationswege reduziert Rauschen. Verknüpfe Alarme mit Aufgaben im Instandhaltungs-Backlog und dokumentiere Maßnahmen, damit Root-Cause-Analysen lernfähig bleiben.
Wer übernimmt die Verantwortung im Alltag?
Benenne eine schlanke Dreierrolle: Linienverantwortliche:r (Entscheidung im Betrieb), Instandhaltung (Maßnahme, MTTR/MTBF), Data/OT-Ansprechpartner:in (Datenqualität, Dashboards). Wöchentliche 15-Minuten-Review: Top-3 Alarme, erledigte Maßnahmen, ein Engpass.
Wie messe ich, ob es wirkt?
Nutze drei Kernmetriken: ungeplante Stillstandsminuten pro Woche, MTBF je Anlage und Anteil „früh erkannter“ Vorfälle (Alarm ≥ X Stunden vor Eingriff). Visualisiere trendbasiert, nicht nur punktuell. Kleine, stetige Verbesserungen zählen.
Was kostet der Einstieg kurzfristig?
Kosten entstehen vor allem in Zeit: Datensäuberung, Schwellen-Setup, Alarm-Routinen. Hardwareseitig oft gering, wenn Basis-Sensorik vorhanden ist. Plane 2–4 Wochen für Pilotzelle und prüfe dann Erweiterung auf ähnliche Anlagen.
Ein letzter Schritt für saubere Kommunikation
Dokumentiere jede neue Regel direkt im Team-Wiki und halte die Alarmtexte knapp und eindeutig. Wenn du deine Inhalte generell klar strukturieren willst, hilft dir dieser Leitfaden zu scanbaren Aufbauten: Die Anatomie des perfekten Listicles. So bleiben auch Schichtwechsel und Übergaben reibungslos.